GLM 5.3 Flash vs DeepSeek v4.1 Flash là chủ đề được nhiều nhà phát triển quan tâm khi lựa chọn mô hình AI có hiệu năng cao, tốc độ phản hồi nhanh và chi phí API hợp lý. Cả hai đều ứng dụng kiến trúc Mixture of Experts (MoE), nhưng có sự khác biệt về khả năng suy luận, lập trình, xử lý đa phương thức và hiệu suất vận hành. Trong bài viết này, TOT sẽ phân tích chi tiết hai mô hình dựa trên các thông số kỹ thuật, benchmark và chi phí sử dụng, giúp doanh nghiệp và nhà phát triển lựa chọn giải pháp phù hợp.
>>> Xem thêm các bài viết:
- DeepSeek Harness: Giải thích kiến trúc Agent và Cordis
- Tìm hiểu về mô hình thị giác DeepSeek: Janus, VL2 và OCR
Tóm tắt nhanh
- GLM 5.3 Flash và DeepSeek V4.1 Flash đều là mô hình AI sử dụng kiến trúc MoE, hỗ trợ context window lên đến 1 triệu token.
- GLM 5.3 Flash nổi bật với khả năng xử lý đa phương thức, hỗ trợ hình ảnh và video trên endpoint tương ứng.
- DeepSeek V4.1 Flash hướng đến các tác vụ reasoning chuyên sâu, lập trình và phát triển AI Agent.
- Cả hai mô hình đều hỗ trợ Function Calling, Tool Calling và tích hợp API để xây dựng workflow tự động hóa.
- GLM 5.3 Flash có lợi thế về chi phí input token, trong khi DeepSeek V4.1 Flash có giá output token thấp hơn.
- DeepSeek V4.1 Flash đạt kết quả nổi bật ở một số benchmark coding và terminal, còn GLM 5.3 Flash có thế mạnh ở một số bài kiểm tra reasoning.
- Việc lựa chọn mô hình nên dựa trên workload, ngân sách API, tốc độ phản hồi và yêu cầu triển khai thực tế thay vì chỉ so sánh điểm benchmark.
Tổng quan về GLM 5.3 Flash và DeepSeek V4.1 Flash
GLM 5.3 Flash vs DeepSeek V4.1 Flash là hai mô hình ngôn ngữ lớn (LLM) ứng dụng kiến trúc Mixture of Experts (MoE), hướng đến mục tiêu cân bằng giữa hiệu năng, tốc độ suy luận và chi phí vận hành. Cả hai đều hỗ trợ context window khoảng 1 triệu token và được phát triển để phục vụ các tác vụ như lập trình, suy luận, xử lý tài liệu và xây dựng AI Agent. Tuy nhiên, hai mô hình có sự khác biệt về kiến trúc kích hoạt tham số và cách tối ưu quá trình xử lý đầu vào, đầu ra.
GLM 5.3 Flash là gì?
GLM 5.3 Flash là mô hình AI do Z.ai phát triển, thuộc dòng GLM-5. Phiên bản Flash hướng đến các ứng dụng cần xử lý khối lượng yêu cầu lớn, độ trễ thấp và tối ưu chi phí, đặc biệt phù hợp với nhà phát triển, doanh nghiệp xây dựng chatbot, AI coding agent và workflow tự động hóa.
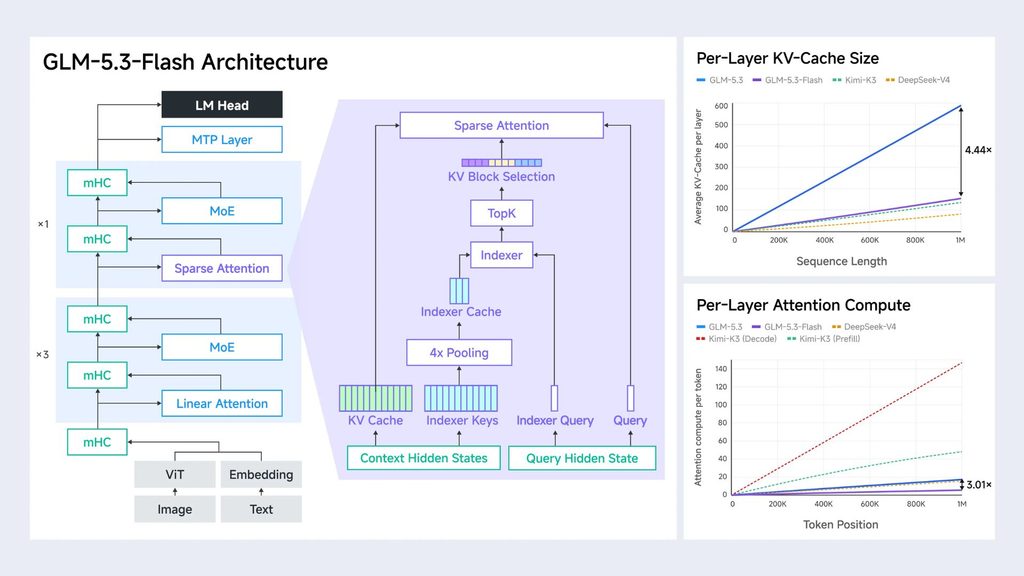
Mô hình sử dụng kiến trúc MoE với 320 tỷ tham số tổng và 18 tỷ tham số được kích hoạt trong mỗi lượt xử lý. Cách tiếp cận này giúp giảm lượng tính toán cần thiết so với việc kích hoạt toàn bộ tham số. Bên cạnh đó, GLM 5.3 Flash kết hợp sparse attention và linear attention nhằm tối ưu hiệu quả xử lý ngữ cảnh dài. Mô hình hỗ trợ context window khoảng 1 triệu token, đồng thời có khả năng tiếp nhận hình ảnh và video bên cạnh văn bản, phục vụ các tác vụ AI đa phương thức.
DeepSeek V4.1 Flash là gì?
DeepSeek V4.1 Flash là mô hình AI do DeepSeek phát triển, tập trung vào khả năng suy luận, lập trình và xử lý tác vụ AI có độ phức tạp cao. Mô hình hướng đến nhà phát triển và doanh nghiệp cần triển khai AI Agent, ứng dụng tự động hóa hoặc hệ thống xử lý dữ liệu quy mô lớn.
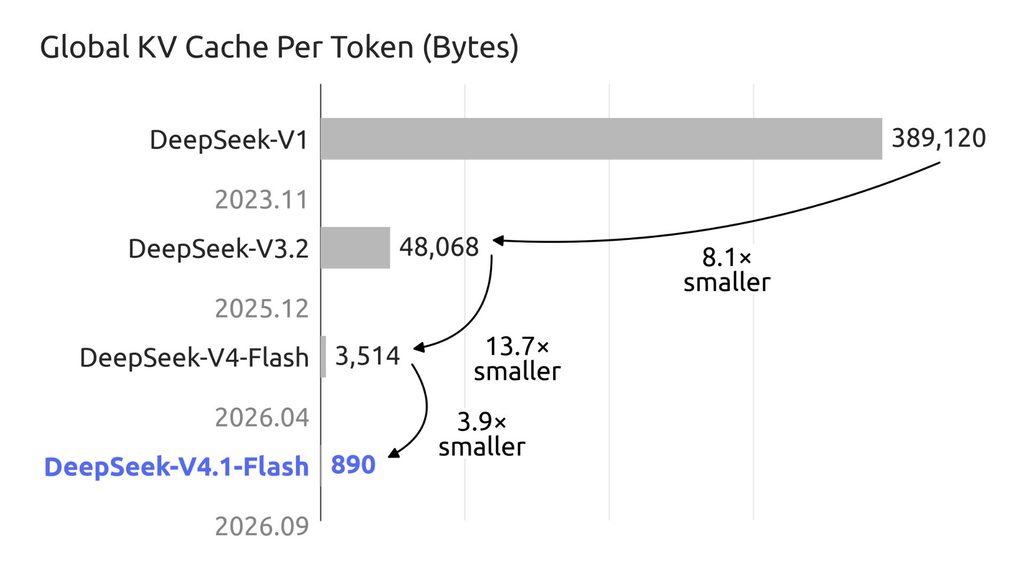
DeepSeek V4.1 Flash sử dụng kiến trúc MoE với 552 tỷ tham số tổng, áp dụng cơ chế kích hoạt bất đối xứng: 8 tỷ tham số cho giai đoạn xử lý đầu vào (prefill) và 16 tỷ tham số cho giai đoạn sinh đầu ra (decode). Kiến trúc Causal Encoder-Decoder (CED) giúp tối ưu việc quản lý KV cache, giảm tài nguyên bộ nhớ cần thiết khi xử lý các chuỗi đầu vào dài.
Mô hình hỗ trợ context window khoảng 1 triệu token, tiếp nhận văn bản và hình ảnh, đồng thời tạo đầu ra dạng văn bản. DeepSeek V4.1 Flash được thiết kế để phục vụ các tác vụ reasoning nhiều bước, tạo mã nguồn, phân tích logic và xử lý thông tin đa phương thức.
>>> Tìm hiểu thêm:
- Model AI mã nguồn mở tự-host 2026: DeepSeek V4, HunYuan 3.0
- Các workflow phổ biến cho AI Agents: Quy trình làm việc
Bảng so sánh GLM 5.3 Flash vs DeepSeek V4.1 Flash
GLM 5.3 Flash vs DeepSeek V4.1 Flash đều sử dụng kiến trúc MoE nhưng khác nhau về quy mô tham số và cách phân bổ tài nguyên tính toán. GLM kích hoạt 18 tỷ tham số, trong khi DeepSeek sử dụng 8 tỷ tham số cho prefill và 16 tỷ cho decode. Cả hai đều hỗ trợ reasoning, coding và xử lý hình ảnh, phù hợp để phát triển AI Agent. Dưới đây là bảng so sánh các thông số chính.
| Tiêu chí | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Nhà phát triển | Z.ai | DeepSeek |
| Kiến trúc | MoE kết hợp Hybrid Sparse Attention và Linear Attention | MoE kết hợp Causal Encoder-Decoder (CED) |
| Tổng tham số | 320 tỷ (320B) | 552 tỷ (552B) |
| Tham số kích hoạt | 18 tỷ (18B) | 8 tỷ (8B) khi xử lý đầu vào và 16 tỷ (16B) khi sinh đầu ra |
| Context window | 1.048.576 token (1,05 triệu) | 1.048.576 token (1,05 triệu) |
| Reasoning | Có hỗ trợ suy luận nhiều bước | Có hỗ trợ suy luận nhiều bước |
| Input | Văn bản, hình ảnh | Văn bản, hình ảnh |
| Output | Văn bản | Văn bản |
| Open weights | Có | Có |
| License | MIT | MIT |
GLM 5.3 Flash có lợi thế về kiến trúc MoE gọn hơn với 18B tham số kích hoạt, phù hợp với các tác vụ lập trình và AI Agent. Trong khi đó, DeepSeek V4.1 Flash nổi bật với kiến trúc CED, cơ chế kích hoạt tham số không đối xứng và khả năng tối ưu bộ nhớ KV Cache. Cả hai đều hỗ trợ context window 1 triệu token và cung cấp trọng số mở theo MIT License.
>>> Tìm hiểu thêm:
- AI trong phát triển phần mềm ứng dụng như thế nào?
- TOP 50+ công cụ AI miễn phí, phổ biến nhất hiện nay
- AI hỗ trợ lập trình ảnh hưởng đến kỹ năng code như thế nào?
So sánh chi tiết GLM 5.3 Flash và DeepSeek V4.1 Flash
GLM 5.3 Flash vs DeepSeek V4.1 Flash hướng đến các ứng dụng AI yêu cầu khả năng suy luận, lập trình và tự động hóa tác vụ. Tuy nhiên, hai mô hình có sự khác biệt về kiến trúc, cơ chế phân bổ tham số và cách tối ưu hiệu suất.
Để lựa chọn mô hình phù hợp, cần đánh giá đồng thời chất lượng đầu ra, khả năng hoàn thành tác vụ, tốc độ phản hồi và chi phí API. Các chỉ số benchmark cần được đối chiếu trên cùng phiên bản mô hình, cấu hình kiểm thử và điều kiện đánh giá. Không nên chỉ dựa vào một điểm số tổng hợp để kết luận mô hình nào tốt hơn.
So sánh hiệu năng và kết quả benchmark
Benchmark giúp đánh giá năng lực mô hình trên các nhóm tác vụ cụ thể, từ kiến thức chuyên sâu đến lập trình và tự động hóa. Một số chỉ số đáng chú ý gồm:
- Intelligence Index: Đánh giá năng lực tổng hợp qua nhiều nhóm bài kiểm tra, phản ánh mức độ thông minh tổng quát của mô hình.
- GPQA Diamond: Kiểm tra khả năng suy luận khoa học ở trình độ sau đại học.
- HLE (Humanity’s Last Exam): Đánh giá khả năng giải quyết các câu hỏi kiến thức phức tạp, đòi hỏi tư duy chuyên sâu.
- AutomationBench: Đo lường khả năng thực hiện quy trình tự động hóa bằng công cụ và API.
- Terminal-Bench: Kiểm tra khả năng thao tác terminal, thực hiện lệnh và hoàn thành tác vụ lập trình trong môi trường thực tế.
- SWE-bench: Đánh giá khả năng xử lý lỗi và thực hiện thay đổi trên các dự án phần mềm thực tế.
Bảng điểm benchmark tham khảo:
| Benchmark | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Intelligence Index (Artificial Analysis) | 27,8 | Chưa có số liệu cùng nguồn |
| GPQA Diamond | 91,2% | 90,9% |
| HLE | 39,9% | 36,8% |
| AutomationBench | 60,4% (AA) | 54,8% |
| Terminal-Bench 2.1 | 84,3% | 90,6% |
| Terminal-Bench 4.0 (AA) | 32,8% | Chưa có số liệu cùng nguồn |
| SWE-bench | 92,0% (Vals AI) | Chưa có số liệu cùng phiên bản benchmark |
GLM 5.3 Flash có điểm GPQA Diamond, HLE và AutomationBench khá nổi bật trong các kết quả được công bố. DeepSeek V4.1 Flash đạt 90,6% trên Terminal-Bench 2.1 và 54,8% trên AutomationBench theo báo cáo của nhà phát triển.
Tuy nhiên, các kết quả trên đến từ những nguồn và cấu hình đánh giá khác nhau. Vì vậy, không nên xem đây là phép so sánh trực tiếp tuyệt đối. Điểm benchmark cũng không phản ánh đầy đủ độ ổn định, tốc độ hay chất lượng khi triển khai thực tế.
>>> Tham khảo thêm:
- AI nhận diện ảnh là gì? Thuật toán & Ứng dụng
- Top 20+ phần mềm AI thiết kế hình ảnh miễn phí, tốt nhất
So sánh khả năng lập trình (Coding)
Cả hai mô hình đều hướng đến lập trình chuyên sâu, hỗ trợ từ tạo mã nguồn đến xử lý tác vụ nhiều bước trong môi trường phát triển phần mềm.
| Tiêu chí | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Tạo code | Sinh mã từ yêu cầu tự nhiên, hỗ trợ nhiều tác vụ lập trình | Hỗ trợ tạo mã, giải thuật và triển khai chức năng |
| Debugging | Phân tích lỗi, đề xuất cách sửa và tối ưu code | Phân tích lỗi, sửa code và kiểm tra kết quả |
| Codebase lớn | Context 1M, hỗ trợ phân tích nhiều tệp và tài liệu | Context 1M, phù hợp phân tích dự án lớn |
| Coding Agent | Hỗ trợ tool calling và quy trình lập trình nhiều bước | Hướng đến coding agent, terminal agent và computer-use agent |
| Tích hợp công cụ | Hỗ trợ function calling | Hỗ trợ function calling và structured output |
GLM 5.3 Flash phù hợp với quy trình phát triển phần mềm cần tạo code, chỉnh sửa nhiều tệp và phối hợp công cụ. DeepSeek V4.1 Flash có lợi thế về thiết kế dành cho tác vụ agentic, đặc biệt là xử lý terminal và hoàn thành công việc qua nhiều bước.
Với dự án lớn, cả hai có thể tận dụng context window 1 triệu token để tiếp nhận nhiều thông tin về cấu trúc dự án. Tuy nhiên, hiệu quả coding agent còn phụ thuộc vào công cụ, môi trường thực thi và khả năng kiểm tra kết quả.
>>> Tham khảo thêm:
- TOP 15 công cụ AI viết báo cáo tốt nhất
- Top 15 công cụ AI phân tích dữ liệu tốt nhất
So sánh khả năng suy luận (Reasoning)
Khả năng reasoning quyết định mức độ hiệu quả khi mô hình xử lý yêu cầu phức tạp, phân tích dữ liệu và giải quyết vấn đề nhiều bước.
| Tiêu chí | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Xử lý nhiều bước | Hỗ trợ lập kế hoạch và thực hiện tác vụ dài | Hỗ trợ điều chỉnh reasoning effort từ 1–100 |
| Phân tích logic | Phù hợp phân tích yêu cầu và giải quyết vấn đề kỹ thuật | Tối ưu cho suy luận nhiều bước và bài toán phức tạp |
| Câu hỏi chuyên sâu | Có kết quả GPQA Diamond 91,2% | Có kết quả GPQA Diamond 90,9% |
| Độ chính xác | Cần kiểm chứng theo từng lĩnh vực và tác vụ | Cần kiểm chứng theo từng lĩnh vực và tác vụ |
| Kiểm soát suy luận | Có thể điều chỉnh reasoning qua cấu hình API | Có thể điều chỉnh mức suy luận liên tục từ 1–100 |
Ví dụ, khi được yêu cầu phân tích nguyên nhân khiến một ứng dụng web thường xuyên bị lỗi, cả hai mô hình có thể chia vấn đề thành các bước: kiểm tra log, xác định thành phần gây lỗi, phân tích nguyên nhân và đề xuất phương án khắc phục.
GLM 5.3 Flash phù hợp với các yêu cầu cần cân bằng giữa suy luận và tốc độ xử lý. Trong khi đó, DeepSeek V4.1 Flash cho phép nhà phát triển điều chỉnh mức reasoning effort linh hoạt hơn. Khi tăng mức suy luận, mô hình có thể dành thêm tài nguyên cho việc giải quyết vấn đề, nhưng cũng có thể làm tăng thời gian phản hồi và lượng token tiêu thụ.
So sánh tốc độ phản hồi và khả năng xử lý
Tốc độ phản hồi ảnh hưởng trực tiếp đến trải nghiệm người dùng và hiệu quả vận hành ứng dụng AI. Khi đánh giá, cần phân biệt các chỉ số:
- Time to First Token (TTFT): Thời gian từ khi gửi yêu cầu đến khi nhận token đầu tiên.
- Time to First Answer Token: Thời gian đến token đầu tiên thuộc phần câu trả lời cuối cùng, không tính riêng token suy luận.
- Output Speed: Tốc độ sinh token trong quá trình tạo phản hồi.
- End-to-End Latency: Tổng thời gian hoàn thành yêu cầu, bao gồm xử lý đầu vào, suy luận và tạo đầu ra.
| Thông số | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| TTFT | Phụ thuộc nhà cung cấp và cấu hình triển khai | Phụ thuộc nhà cung cấp và cấu hình triển khai |
| First Answer Token | Chưa có số liệu chuẩn hóa | Chưa có số liệu chuẩn hóa |
| Output Speed | Khoảng 121–180 token/giây ở một số provider OpenRouter | Khoảng 110–177 token/giây ở một số provider OpenRouter |
| End-to-End Latency | Thay đổi theo độ dài prompt và tác vụ | Thay đổi theo độ dài prompt và tác vụ |
| Xử lý đồng thời | Có thể mở rộng theo hạ tầng inference | Hỗ trợ concurrency cao trên API chính thức |
Tốc độ sinh token cao không đồng nghĩa với việc hoàn thành tác vụ nhanh hơn. Chẳng hạn, một coding agent có thể sinh code nhanh nhưng vẫn mất nhiều thời gian đọc tài liệu, gọi API, chạy thử và sửa lỗi.
Vì vậy, nên đánh giá End-to-End Latency trên cùng workload thay vì chỉ so sánh tokens/second. Các con số throughput trong bảng là số liệu của một số nhà cung cấp, không phải tốc độ cố định của kiến trúc mô hình.
>>> Xem thêm:
- TOP 15+ công cụ AI viết code miễn phí, hiệu quả cho lập trình viên
- So sánh Low-Code và No-Code: Sự khác biệt & Ứng dụng thực tế
So sánh chi phí API
Chi phí API phụ thuộc vào số lượng token đầu vào, đầu ra, token được đọc từ cache và nhà cung cấp inference. Theo dữ liệu giá tổng hợp trên OpenRouter tại thời điểm tra cứu:
| Tiêu chí | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Input trung bình | $0.03988 | $0.0498 |
| Output trung bình | $0.3999 | $0.1992 |
| Cache Read | Thay đổi theo provider | Thay đổi theo provider |
Đơn vị: USD/1 triệu token. Đây là giá trung bình có trọng số theo dữ liệu OpenRouter, không phải giá cố định của API chính chủ. Giá có thể thay đổi theo provider và thời điểm.
Ví dụ tính chi phí: Giả sử một ứng dụng AI sử dụng 10 triệu token đầu vào và 2 triệu token đầu ra mỗi tháng, không tính cache:
- GLM 5.3 Flash: (10 × $0.03988) + (2 × $0.3999) = $1.1986.
- DeepSeek V4.1 Flash: (10 × $0.0498) + (2 × $0.1992) = $0.8964.
Trong workload giả định này, DeepSeek V4.1 Flash có tổng chi phí thấp hơn khoảng 25%. GLM 5.3 Flash có lợi thế khi khối lượng token đầu vào lớn nhưng đầu ra ngắn. Ngược lại, DeepSeek phù hợp hơn với workload có lượng token đầu ra tương đối cao.
Đối với chatbot, coding agent và hệ thống AI quy mô lớn, doanh nghiệp nên tính thêm chi phí cache, số lần gọi công cụ và token reasoning trước khi lựa chọn.
>>> Tham khảo thêm:
- So sánh Gói AI vs API Token AI: Chọn đúng khi tích hợp AI vào phần mềm
- Cách tạo ứng dụng bằng AI miễn phí, chi tiết, đơn giản
So sánh context window và khả năng xử lý đa phương thức
Cả hai mô hình đều hỗ trợ context window 1 triệu token, cho phép tiếp nhận lượng thông tin lớn trong một phiên làm việc.
| Tiêu chí | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Context window | 1.048.576 token | 1.048.576 token |
| Tài liệu dài | Hỗ trợ phân tích tài liệu và dữ liệu lớn | Hỗ trợ phân tích tài liệu và dữ liệu lớn |
| Hình ảnh đầu vào | Có | Có |
| Văn bản đầu vào | Có | Có |
| Video đầu vào | Có trên endpoint hỗ trợ | Chưa xác nhận hỗ trợ video |
| Đầu ra hình ảnh | Không | Không |
| Đầu ra văn bản | Có | Có |
Ví dụ ứng dụng:
- GLM 5.3 Flash: Phân tích tài liệu kỹ thuật, đọc hình ảnh giao diện, xử lý nội dung video trên endpoint tương ứng và hỗ trợ xây dựng ứng dụng AI đa phương thức.
- DeepSeek V4.1 Flash: Phân tích hình ảnh sản phẩm, đọc biểu đồ, xử lý tài liệu dài và hỗ trợ các tác vụ cần kết hợp dữ liệu văn bản với hình ảnh.
Context window lớn không đồng nghĩa mô hình luôn xử lý chính xác toàn bộ tài liệu. Hiệu quả còn phụ thuộc vào khả năng truy xuất thông tin, chất lượng dữ liệu đầu vào và giới hạn token đầu ra của endpoint.
Đặc biệt, DeepSeek API hiện công bố giới hạn đầu ra tối đa 384K token, trong khi OpenRouter công bố giới hạn 1.048.576 token trên trang model. Vì vậy, cần kiểm tra giới hạn theo endpoint sử dụng.
>>> Tìm hiểu thêm:
- Dola AI là gì? Trợ lý AI hỗ trợ công việc & học tập hiệu quả
- Chip AI là gì? Tính năng và ứng dụng nổi bật
So sánh khả năng tích hợp AI Agent và sử dụng công cụ
Cả GLM 5.3 Flash vs DeepSeek V4.1 Flash đều hỗ trợ Function Calling, cho phép mô hình tương tác với API, cơ sở dữ liệu và công cụ bên ngoài.
| Tiêu chí | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Function Calling | Hỗ trợ kết nối với các hàm và API do nhà phát triển định nghĩa. | Hỗ trợ gọi hàm và tương tác với công cụ bên ngoài. |
| Tool Calling | Thực hiện các bước như truy vấn dữ liệu, xử lý thông tin và trả kết quả. | Hỗ trợ gọi công cụ để thực hiện chuỗi tác vụ nhiều bước. |
| Structured Output | Hỗ trợ định dạng đầu ra có cấu trúc. | Hỗ trợ Structured Output, chuẩn hóa dữ liệu theo JSON Schema. |
| Tích hợp AI Agent | Phù hợp xây dựng chatbot doanh nghiệp, trợ lý lập trình và workflow tự động hóa. | Hướng đến coding agent, terminal agent và computer-use agent. |
| Xử lý tác vụ dài | Context window 1 triệu token, hỗ trợ duy trì ngữ cảnh trong các quy trình nhiều bước. | Context window 1 triệu token, hỗ trợ xử lý các tác vụ có ngữ cảnh dài. |
| Tích hợp API | Hỗ trợ kết nối API và công cụ bên ngoài thông qua Function Calling. | Hỗ trợ DeepSeek API, OpenAI-compatible API và Anthropic API. |
GLM 5.3 Flash phù hợp với hệ thống cần kết hợp xử lý văn bản, hình ảnh, video và tự động hóa quy trình. DeepSeek V4.1 Flash có định hướng rõ ràng hơn đối với các ứng dụng AI Agent cần gọi công cụ, thao tác terminal và hoàn thành tác vụ kỹ thuật nhiều bước.
Tuy nhiên, khả năng thực thi thực tế còn phụ thuộc vào framework điều phối, quyền truy cập công cụ và cơ chế kiểm soát lỗi của ứng dụng.
>>> Tìm hiểu thêm:
- Top 20 công cụ AI viết content nhanh, chuẩn SEO hiện nay
- AI dịch thuật là gì? Top 25 công cụ AI tốt nhất hiện nay
- Hướng dẫn triển khai AI trong ứng dụng di động đơn giản
Ưu và nhược điểm của GLM 5.3 Flash và DeepSeek V4.1 Flash
GLM 5.3 Flash vs DeepSeek V4.1 Flash đều có những lợi thế riêng về kiến trúc, hiệu năng và khả năng triển khai. GLM nổi bật với khả năng xử lý đa phương thức và tối ưu tài nguyên tính toán, trong khi DeepSeek có lợi thế về tốc độ sinh đầu ra và kiến trúc kích hoạt bất đối xứng. Tuy nhiên, mỗi mô hình vẫn tồn tại những hạn chế cần cân nhắc trước khi đưa vào ứng dụng thực tế.
Ưu và nhược điểm của GLM 5.3 Flash
Ưu điểm:
- Kiến trúc MoE kết hợp Hybrid Attention giúp cân bằng hiệu năng và tài nguyên tính toán.
- Hỗ trợ xử lý văn bản, hình ảnh và video trên các endpoint tương thích.
- Context window lớn, phù hợp phân tích tài liệu dài và codebase phức tạp.
- Chi phí API cạnh tranh, phù hợp triển khai chatbot và AI Agent quy mô lớn.
Nhược điểm:
- Hiệu năng reasoning và coding cần được kiểm chứng theo từng workload.
- Giới hạn output token và khả năng xử lý đa phương thức có thể khác nhau giữa các nhà cung cấp API.
- Tốc độ sinh đầu ra có thể thấp hơn một số mô hình Flash cạnh tranh.
Ưu và nhược điểm của DeepSeek V4.1 Flash
Ưu điểm:
- Kiến trúc MoE bất đối xứng giúp tối ưu tài nguyên cho giai đoạn prefill và decode.
- Tốc độ sinh đầu ra cao, phù hợp ứng dụng cần phản hồi nhanh.
- Hỗ trợ reasoning nhiều bước, coding và xây dựng AI Agent.
- Context window lớn, hỗ trợ xử lý văn bản và hình ảnh.
Nhược điểm:
- Chi phí API thay đổi theo khung giờ, cấu hình endpoint và nhà cung cấp.
- Hiệu quả tiết kiệm phụ thuộc vào tỷ lệ cache hit và lượng token sử dụng.
- Kết quả thực tế có thể khác biệt tùy độ phức tạp của tác vụ và cấu hình triển khai.
>>> Tham khảo thêm:
- Top 22 công cụ chỉnh ảnh AI miễn phí, đẹp nhất
- Top 20 công cụ AI viết content nhanh, chuẩn SEO hiện nay
Nên chọn GLM 5.3 Flash hay DeepSeek V4.1 Flash?
Việc lựa chọn giữa GLM 5.3 Flash và DeepSeek V4.1 Flash phụ thuộc vào mục tiêu sử dụng, ngân sách và yêu cầu kỹ thuật của từng dự án. Mỗi mô hình có thế mạnh riêng, phù hợp với những nhóm nhu cầu khác nhau.
Khi nào nên chọn GLM 5.3 Flash?
GLM 5.3 Flash là lựa chọn đáng cân nhắc nếu dự án cần:
- Xử lý đa phương thức: Phù hợp với ứng dụng cần phân tích hình ảnh hoặc kết hợp dữ liệu đa phương thức, tùy khả năng hỗ trợ của API được triển khai.
- Tối ưu chi phí token: Có thể phù hợp với chatbot, hệ thống hỏi đáp hoặc ứng dụng có lượng truy vấn lớn khi mức giá API đáp ứng ngân sách.
- Phát triển AI Agent: Có thể tích hợp vào chatbot, workflow tự động hóa và hệ thống sử dụng công cụ bên ngoài.
Khi nào nên chọn DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash phù hợp hơn với các nhu cầu như:
- Lập trình và reasoning: Đáng thử nghiệm cho các tác vụ phân tích yêu cầu, viết mã, gỡ lỗi và giải quyết vấn đề nhiều bước.
- Tốc độ sinh đầu ra: Là lựa chọn cần đánh giá nếu ứng dụng yêu cầu phản hồi nhanh hoặc tạo lượng nội dung lớn.
- Hệ sinh thái DeepSeek: Phù hợp với đội ngũ muốn tận dụng API, công cụ và hạ tầng hiện có trong hệ sinh thái này.
Mô hình nào phù hợp hơn cho doanh nghiệp và nhà phát triển?
Doanh nghiệp nên đánh giá cả hai mô hình dựa trên ngân sách, workload, hạ tầng triển khai, yêu cầu bảo mật và khả năng mở rộng. Nhà phát triển cũng cần kiểm tra độ ổn định, độ trễ và chất lượng đầu ra trên môi trường thực tế.
Nhìn chung, không có mô hình chiến thắng tuyệt đối. GLM 5.3 Flash đáng cân nhắc cho nhu cầu đa phương thức và tối ưu chi phí. DeepSeek V4.1 Flash phù hợp để thử nghiệm với tác vụ lập trình, reasoning và yêu cầu tốc độ. Cách lựa chọn đáng tin cậy nhất là chạy thử cả hai trên cùng bộ dữ liệu và tiêu chí đánh giá trước khi triển khai.
>>> Xem thêm:
- Flow AI là gì? Hướng dẫn tạo video & hình ảnh bằng Google Flow
- Hướng dẫn cách sử dụng Google AI Studio hiệu quả, nhanh chóng
- TOP 15+ công cụ tạo app bằng AI hiệu quả, siêu dễ
So sánh chi phí sử dụng GLM 5.3 Flash và DeepSeek V4.1 Flash
Chi phí API của GLM 5.3 Flash và DeepSeek V4.1 Flash tương đối cạnh tranh, nhưng có sự khác biệt ở giá token đầu ra, token đầu vào được lưu cache và khung giờ tính phí.
Bảng dưới đây sử dụng mức giá API tiêu chuẩn tính bằng USD trên mỗi 1 triệu token.
| Tiêu chí | GLM 5.3 Flash | DeepSeek V4.1 Flash |
|---|---|---|
| Input token (cache miss) | $0.15 | $0.15 (off-peak) |
| Input token (cache hit) | $0.03 | $0.003 (off-peak) |
| Output token | $0.50 | $0.60 (off-peak) |
| Input token giờ cao điểm | Không áp dụng giá cao điểm riêng | $0.30 |
| Output token giờ cao điểm | Không áp dụng giá cao điểm riêng | $1.20 |
Nguồn: Mức giá GLM 5.3 Flash trên OpenRouter và bảng giá API chính thức của DeepSeek. Giá có thể thay đổi theo nhà cung cấp và thời điểm sử dụng.
Phân tích mức chênh lệch chi phí
Với 1 triệu input token không cache và 1 triệu output token, GLM 5.3 Flash có tổng chi phí khoảng 0,65 USD, trong khi DeepSeek V4.1 Flash có chi phí 0,75 USD vào giờ thấp điểm. Như vậy, GLM tiết kiệm khoảng 0,10 USD, tương đương 13,3% cho khối lượng token giả định này.
Tuy nhiên, DeepSeek có lợi thế đáng kể về giá input token khi cache hit: 0,003 USD, thấp hơn 10 lần so với mức 0,03 USD của GLM. Vì vậy, với các ứng dụng thường xuyên gửi lại system prompt hoặc ngữ cảnh cố định, DeepSeek có thể giảm đáng kể chi phí đầu vào.
Mô hình nào tiết kiệm hơn khi xử lý khối lượng yêu cầu lớn?
GLM 5.3 Flash có lợi thế về giá output và mức phí ổn định giữa các khung giờ. Trong khi đó, DeepSeek V4.1 Flash có thể tối ưu ngân sách tốt hơn với workload có tỷ lệ cache hit cao và được phân bổ vào giờ thấp điểm. Doanh nghiệp nên tính tổng chi phí dựa trên tỷ lệ cache, số lượng input/output token và thời gian gửi yêu cầu, thay vì chỉ so sánh giá niêm yết.
Kết luận
Nhìn chung, GLM 5.3 Flash vs DeepSeek V4.1 Flash là hai mô hình AI có thế mạnh riêng về hiệu năng, khả năng reasoning, lập trình và tối ưu chi phí. GLM 5.3 Flash phù hợp với các ứng dụng đa phương thức, chatbot và workflow tự động hóa. Trong khi đó, DeepSeek V4.1 Flash là lựa chọn đáng cân nhắc cho coding agent, tác vụ reasoning chuyên sâu và ứng dụng cần tối ưu chi phí đầu ra. Doanh nghiệp và nhà phát triển nên dựa trên workload, ngân sách API và yêu cầu kỹ thuật thực tế để lựa chọn mô hình phù hợp, thay vì chỉ đánh giá qua benchmark.
Câu hỏi thường gặp
GLM 5.3 Flash có tốt hơn DeepSeek V4.1 Flash không?
Không có mô hình nào tốt hơn trong mọi trường hợp. GLM 5.3 Flash phù hợp với nhu cầu xử lý đa phương thức và tự động hóa workflow. DeepSeek V4.1 Flash nổi bật ở khả năng lập trình, reasoning và tốc độ sinh đầu ra. Bạn nên lựa chọn dựa trên workload, ngân sách API và yêu cầu kỹ thuật của ứng dụng.
GLM 5.3 Flash và DeepSeek V4.1 Flash có miễn phí không?
Cả GLM 5.3 Flash và DeepSeek V4.1 Flash đều cung cấp trọng số mở theo giấy phép MIT. Tuy nhiên, sử dụng API chính thức không đồng nghĩa với miễn phí. Người dùng cần thanh toán theo lượng token đầu vào và đầu ra, trừ khi nhà cung cấp có chương trình cấp credit hoặc ưu đãi riêng.
Có thể sử dụng GLM 5.3 Flash và DeepSeek V4.1 Flash miễn phí không?
Có. Bạn có thể tải trọng số mô hình để tự triển khai trên hạ tầng tương thích mà không phải trả phí bản quyền theo MIT License. Ngoài ra, một số nền tảng có thể cung cấp credit dùng thử hoặc hạn mức miễn phí. Tuy nhiên, chi phí máy chủ, GPU và vận hành vẫn cần được tính đến.
GLM 5.3 Flash vs DeepSeek V4.1 Flash model nào nhanh hơn?
DeepSeek V4.1 Flash có lợi thế về tốc độ sinh token trong một số kết quả đo lường độc lập. Tuy nhiên, tốc độ thực tế phụ thuộc vào provider, cấu hình phần cứng, độ dài prompt và mức reasoning. Bạn nên kiểm tra cả TTFT, Output Speed và End-to-End Latency trước khi lựa chọn.
Context Window của GLM 5.3 Flash và DeepSeek V4.1 Flash là bao nhiêu?
Cả GLM 5.3 Flash và DeepSeek V4.1 Flash đều hỗ trợ context window tối đa 1.048.576 token (1M). Dung lượng này cho phép mô hình tiếp nhận và phân tích tài liệu dài, mã nguồn hoặc lượng lớn dữ liệu trong một phiên làm việc. Giới hạn token đầu ra của hai mô hình có thể khác nhau tùy endpoint.
Nguồn tham khảo: